
Webdesign für Publisher & Verlage Digitale Publishing-Plattformen für Redaktion, Abonnement, Vermarktung und organische Reichweite
Ein Verlag produziert fortlaufend neue Inhalte, während gleichzeitig Jahre an Artikeln, Autorenwissen, Kategorien und Medien im System weiterleben. Genau diese Kombination macht einen Relaunch anspruchsvoll: Die Oberfläche darf moderner werden, ohne redaktionelle Abläufe, gewachsene Suchsignale oder Erlösstrecken zu beschädigen.
RheinMainTech konzipiert Publishing-Websites auf WordPress-Basis mit klaren Inhaltstypen, eigener Komponentenentwicklung und anschließbarem Hosting. Wir denken Newsroom, Archiv, Newsletter, Abonnement, Vermarktung und Auffindbarkeit gemeinsam. Dadurch entsteht eine Plattform, die tägliches Publizieren erleichtert und zugleich nachvollziehbar ausweist, von wem ein Inhalt stammt, wann er aktualisiert wurde und in welchen Themenzusammenhang er gehört.
Für Publisher ist der Relaunch dann gelungen, wenn die Redaktion schneller wird, der historische Bestand kontrolliert migriert ist und jedes neue Stück Content einen klaren Platz im digitalen Wissensangebot besitzt.


Wo Verlagswebsites im Alltag Reibung erzeugen

Das CMS folgt nicht dem Takt des Newsrooms
Eilmeldung, Autorenwechsel, Dossier, Sonderseite oder neue Ausgabe: Muss für wiederkehrende Redaktionsaufgaben erst technische Hilfe organisiert werden, bestimmt das Ticketsystem die Publikationsgeschwindigkeit. Bei wechselnden Teams entstehen zusätzlich uneinheitliche Seitentypen und improvisierte Workarounds.
Das Archiv verteilt Autorität auf zu viele ungeklärte Pfade
Alte Rubriken, Tags, Paginierungen, Druckansichten, frühere URL-Schemata und mehrfach eingespielte Inhalte können über Jahre eine unübersichtliche Indexlandschaft erzeugen. Ohne Bestandsaufnahme droht ein Relaunch genau jene Artikelbeziehungen und externen Verweise zu zerreißen, die sich über lange Zeit aufgebaut haben.
Publishing-Technik, die Inhalte nicht ausbremst.
Unsere Architektur trennt redaktionelle Geschwindigkeit von technischer Improvisation. Der Verlag erhält definierte Inhaltstypen, anschließbare Erlösdienste und eine Betriebsbasis, auf der neue Themen ohne jedes Mal neue Sonderlösungen entstehen.
Redaktionsarchitektur
Artikel, Meldungen, Dossiers, Autorenprofile, Themenhubs und Archive erhalten ein Content-Modell, das den tatsächlichen Ablauf im Verlag abbildet.
WordPress für Newsrooms
Redaktionelle Seitentypen, Teaserlogik und wiederkehrende Module entstehen in einer Form, die Redakteure ohne Layoutcode oder technische Umwege bedienen können.
Archiv- und URL-Migration
Bestehende Beiträge, Kategorien, Medien und Weiterleitungen werden vor dem Relaunch inventarisiert, damit Reichweite und historische Verlinkungen nicht beiläufig verloren gehen.
Abo- und Erlösanbindungen
Newsletter, Bezahlschranken, Abonnementstrecken, Anzeigenvermarktung oder CRM-Systeme lassen sich über definierte Schnittstellen an die Publishing-Plattform koppeln.
Quellenprofil für KI-Suche
Autorenschaft, Aktualisierung, Themenzuordnung und redaktionelle Belege werden im sichtbaren Inhalt präzise geführt, damit Veröffentlichungen einen belastbaren Herkunftskontext besitzen.
Betrieb unter Publikationsdruck
Caching, Monitoring, Sicherheitsupdates und Lastverhalten werden auf regelmäßige Veröffentlichungen, umfangreiche Archive sowie kurzfristige Reichweitenspitzen ausgelegt.
Erst das Publikationsmodell verstehen,
dann den Bestand bewegen.
Vor Gestaltung oder Migration erfassen wir, wie Inhalte entstehen, welche Systeme Umsatz oder Leserbindung stützen und welche URLs heute tatsächlich Reichweite tragen.
Newsroom-Audit
Wir erfassen Rollen, Inhaltstypen, Freigaben, Autorenpflege, Medienablage, Suchfunktion sowie technische Abhängigkeiten im laufenden Redaktionsbetrieb.
Bestandsmodell
Artikelserien, Ressorts, Tags, Autoren, Archive und Erlöswege werden in eine Zielarchitektur überführt; daraus entstehen Regeln für URLs, interne Verlinkung und Migration.
Plattformwechsel
Frontend, WordPress-Komponenten, Datenübernahme und Integrationen werden schrittweise umgesetzt, während Redirects und Indexsignale separat kontrolliert werden.
Redaktionsstart
Vor dem Go-live testen reale Redakteure typische Aufgaben; anschließend dokumentieren wir genau diese Routinen in kompakten kundenspezifischen Lernvideos.
Webagentur für Publisher, Fachverlage & Medienhäuser Der eigentliche Wert steckt im Content-Bestand – nicht nur im neuen Erscheinungsbild
Eine Verlagsplattform trägt mehr Beziehungen als eine gewöhnliche Unternehmensseite. Beitrag und Autor gehören zusammen; ein Autor steht für Themen; Themen verdichten sich zu Ressorts, Serien oder Dossiers; einzelne Veröffentlichungen verweisen auf ältere Beiträge, Downloads, Veranstaltungen oder Abonnements. Wir bilden diese Zusammenhänge bewusst im Informationsmodell ab, statt sie nur über eine Hauptnavigation zu überdecken.
Bei großen Archiven beginnt die Arbeit deshalb mit Inventarisierung. Wir unterscheiden Inhalte, die weitergeführt werden, von Dubletten, veralteten Taxonomien und Seiten ohne eigenständige Aufgabe. Aus dieser Entscheidung folgen Migrationslisten, Redirect-Ziele, Canonical-Regeln und interne Verknüpfungen. So wird der Relaunch zu einer kontrollierten Neuordnung des Bestands.
Für den täglichen Betrieb bekommt die Redaktion robuste Bausteine statt eines freien Baukastens ohne Leitplanken. Artikelköpfe, Autorenmodule, Zitatblöcke, Newsletter-Promos, Dossier-Einstiege oder Vermarktungsflächen können als wiederverwendbare Komponenten bereitstehen. Redaktionelle Freiheit bleibt erhalten, ohne dass jedes Sonderformat neuen Template-Code benötigt.
Externe Systeme müssen deshalb nicht ersetzt werden. Bestehende Newsletter-Dienste, Abo-Verwaltung, CRM, Paywall, Anzeigen- oder Eventsysteme können weiterarbeiten und über Schnittstellen eingebunden werden. Wo eine zentrale Funktion kundenspezifische Logik erfordert, entwickeln wir sie selbst; Betrieb und Wartung können über RheinMainTech aus einer technischen Verantwortung kommen.
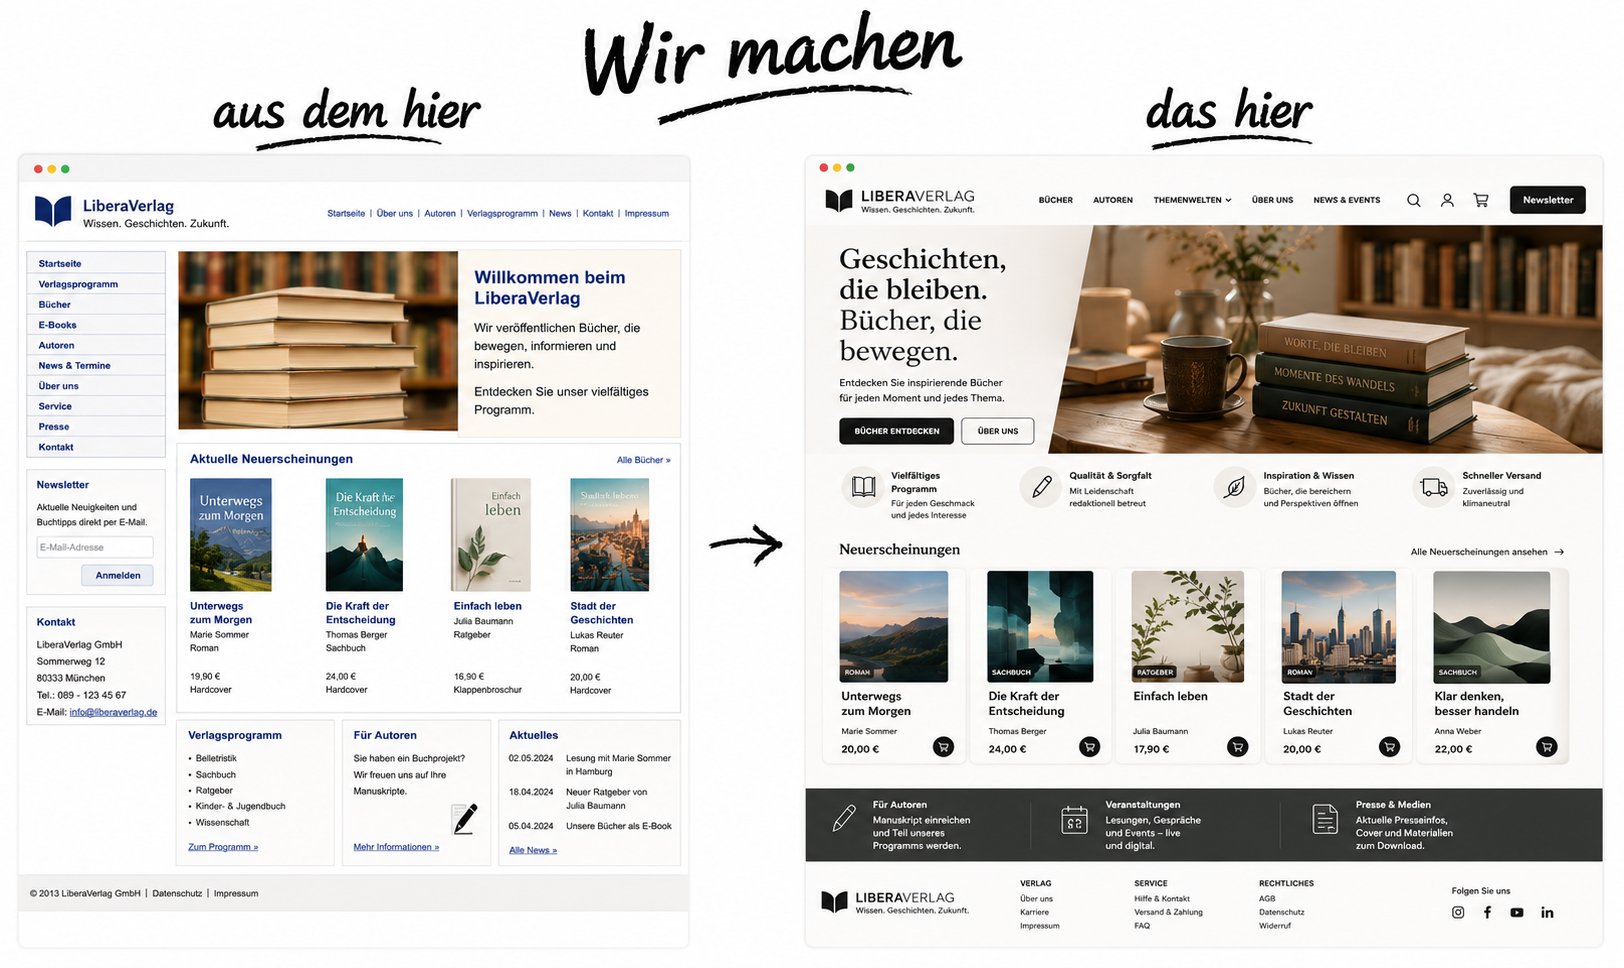
Als redaktionelle Quelle erkennbar bleiben Publisher-SEO für Google-Suche, AI Overviews und generative Recherche
Bei informationsorientierten Suchen werden einzelne Veröffentlichungen nicht nur über ihren Titel bewertet. Herkunft, Autor, Aktualität, thematische Einordnung und Verweise auf vertiefende Inhalte helfen dabei, einen Beitrag in einen belastbaren redaktionellen Zusammenhang zu stellen. Für Verlage ist diese Quellenidentität ein strategischer Vermögenswert.
Google beschreibt für seine generativen Suchfunktionen weiterhin dieselben grundlegenden SEO-Anforderungen wie für die klassische Suche: Inhalte müssen indexierbar, hilfreich und technisch zugänglich sein. Deshalb bauen wir keine vermeintliche Sonderoptimierung für AI Overviews, sondern verbessern die Voraussetzungen, unter denen Artikel, Dossiers und Autorenprofile zuverlässig gefunden sowie verstanden werden können.
Gleichzeitig berücksichtigen wir neue Recherchewege. Wenn ein System zu einer komplexen Frage mehrere Teilaspekte sucht, sollte der Verlag nicht nur einen langen Sammeltext besitzen, sondern präzise Seiten zu Autoren, Themen, Serien und Fachgebieten. Diese Struktur vergrößert die Zahl sinnvoller Einstiege in den eigenen Bestand.

Artikel werden zu einem nachvollziehbaren Publikationsnetz Autor, Ressort, Thema, Veröffentlichungsdatum und Folgebeitrag erhalten feste Beziehungen
Ein Beitrag gewinnt Kontext, wenn Leser und Maschinen erkennen können, wer ihn verantwortet, welche Ausgabe oder Rubrik dazugehört und welche weiterführenden Stücke denselben Gegenstand vertiefen. Dafür gestalten wir Autorenprofile, Themenarchive und Serienseiten nicht als Nebenprodukte, sondern als verbindende Knoten des redaktionellen Bestands.
Aktualisierungen werden sichtbar geführt, statt still alte Aussagen zu überschreiben. Bei Evergreen-Inhalten kann eine gepflegte Änderungsinformation entscheidend sein; bei Nachrichten bleibt dagegen das ursprüngliche Veröffentlichungsdatum wesentlich. Solche redaktionellen Signale müssen im Frontend und in den technischen Metadaten zusammenpassen.
Auf Artikelseiten kann Article-, NewsArticle- oder BlogPosting-Markup sinnvoll sein, sofern die ausgezeichneten Angaben tatsächlich sichtbar und korrekt gepflegt werden. Autor, Überschrift, Bilder sowie Veröffentlichungs- und Änderungszeitpunkt gehören zu den Informationen, die Google für Artikel strukturiert auswerten kann. Eine technische Auszeichnung ersetzt jedoch keine belastbare Byline oder ein echtes Autorenprofil.
Zusätzlich prüfen wir Crawling, Canonicals, Pagination, Sitemaps, Statuscodes und Weiterleitungen. Besonders bei historischen Archiven entscheidet diese technische Hygiene darüber, ob Suchsysteme den neuen Aufbau als konsistente Fortführung oder als unübersichtlichen Neustart erleben.

Der Newsroom veröffentlicht ohne Layout-Warteschleife Themenspecials und Vermarktungsseiten entstehen aus redaktionell freigegebenen Modulen
Sonderausgabe, Branchendossier, Sponsorenschwerpunkt oder neuer Newsletter-Funnel dürfen nicht jedes Mal ein Mini-Relaunch werden. Wir legen dafür definierte Komponenten an, aus denen die Redaktion neue Seiten zusammensetzen kann. Typografie, Abstände, Teaserlogik und responsives Verhalten bleiben automatisch innerhalb des Designsystems.
KI kann an dieser Stelle Produktionsarbeit übernehmen: Ein strukturiertes Briefing kann in einen vollständigen Seitenentwurf mit passenden Inhaltsmodulen übersetzt werden. Faktenprüfung, Rechtefragen, Quellenwahl und redaktionelle Freigabe bleiben bewusst beim Verlag. Die Automatisierung verkürzt den Weg bis zum Entwurf, nicht die publizistische Verantwortung.
Technische Kontrolle statt Plugin-Sammelsurium
Der Kern nutzt WordPress als frei verfügbares Fundament mit klar definierten Komponenten. Erlös-, Newsletter- oder Redaktionsdienste können angebunden bleiben; eigene Erweiterungen setzen wir dort ein, wo das Verlagsmodell besondere Logik verlangt. Updates, Überwachung und Infrastruktur können über RheinMainTech zentral verantwortet werden.
Das verändert die Wirtschaftlichkeit des laufenden Webbetriebs. Neue Landingpages, Dossiers oder Partnerformate benötigen weniger externe Produktionszeit, während die Redaktion trotzdem innerhalb eines kontrollierten Systems arbeitet. Wiederkehrende Aufgaben werden schneller, ohne dass die Plattform bei jeder Kampagne weiter fragmentiert.
Auch die Weiterentwicklung wird planbarer: Statt viele kleine Notlösungen zu pflegen, kann der Verlag neue Funktionen an stabilen Inhaltstypen und dokumentierten Schnittstellen ergänzen. Das schützt den täglichen Publikationsbetrieb und erleichtert spätere technische Entscheidungen.

Redaktionswissen wird Teil der Übergabe Kurze Lernvideos dokumentieren genau die Aufgaben Ihres Newsrooms
Statt eines allgemeinen CMS-Handbuchs zeigen wir die konkreten Handgriffe des neuen Verlagsauftritts: Autoren anlegen, Beiträge aktualisieren, Dossiers pflegen, Teaser tauschen, Newsletter-Flächen einsetzen oder eine Sonderseite aus vorhandenen Modulen aufbauen.
Diese Videos bleiben als internes Nachschlagewerk verfügbar und erleichtern die Einarbeitung neuer Kolleginnen und Kollegen. Komplexe Integrationen, Serverbetrieb oder Weiterentwicklung müssen dadurch nicht in die Redaktion verlagert werden; sie können weiterhin technisch betreut bleiben.
Webdesign für Publisher und Verlage ist deshalb vor allem Architekturarbeit am publizistischen Bestand. Eine gute Plattform bewahrt historische Reichweite, macht Autorenschaft sichtbar, beschleunigt tägliche Veröffentlichungen und lässt Erlösdienste sauber andocken.
RheinMainTech verbindet dafür Informationsmodell, UX, WordPress-Engineering, Migration, Schnittstellen und Betrieb mit einer Suchstrategie, die redaktionelle Quellenqualität ernst nimmt. Das Ergebnis soll nicht nur moderner aussehen, sondern den Newsroom jeden Tag spürbar besser unterstützen.